LLM AI로 간식 추천 서비스 만들기
2026. 9. 15.
스낵링크는 사무실 간식 큐레이션 서비스였습니다. 회사 총무 담당자가 탕비실 간식을 고르는 데 생각보다 시간이 많이 드는데, 그걸 1분 안에 끝내 보자는 게 목표였어요.
AI 챗은 대표님의 오더로 시작했습니다. "사무실 간식 5만원어치 알려줘"처럼 말만 하면 간식 구성을 짜 주는 기능이요. 개발은 백엔드 개발자 한 분과 저, 둘이서 했습니다. GPT를 부르고 결과를 가공하는 건 백엔드, 그 응답을 받아 화면에 풀어내는 건 제 몫이었어요. 둘이서 서비스 전체를 만든 이야기는 따로 써 보려고 합니다.
이번 글은 그중 AI 챗 이야기입니다. 백엔드와 프론트가 LLM을 어떻게 나눠 맡았는지, 그리고 AI가 없는 간식을 추천하던 문제를 어떻게 잡았는지를 정리했습니다.
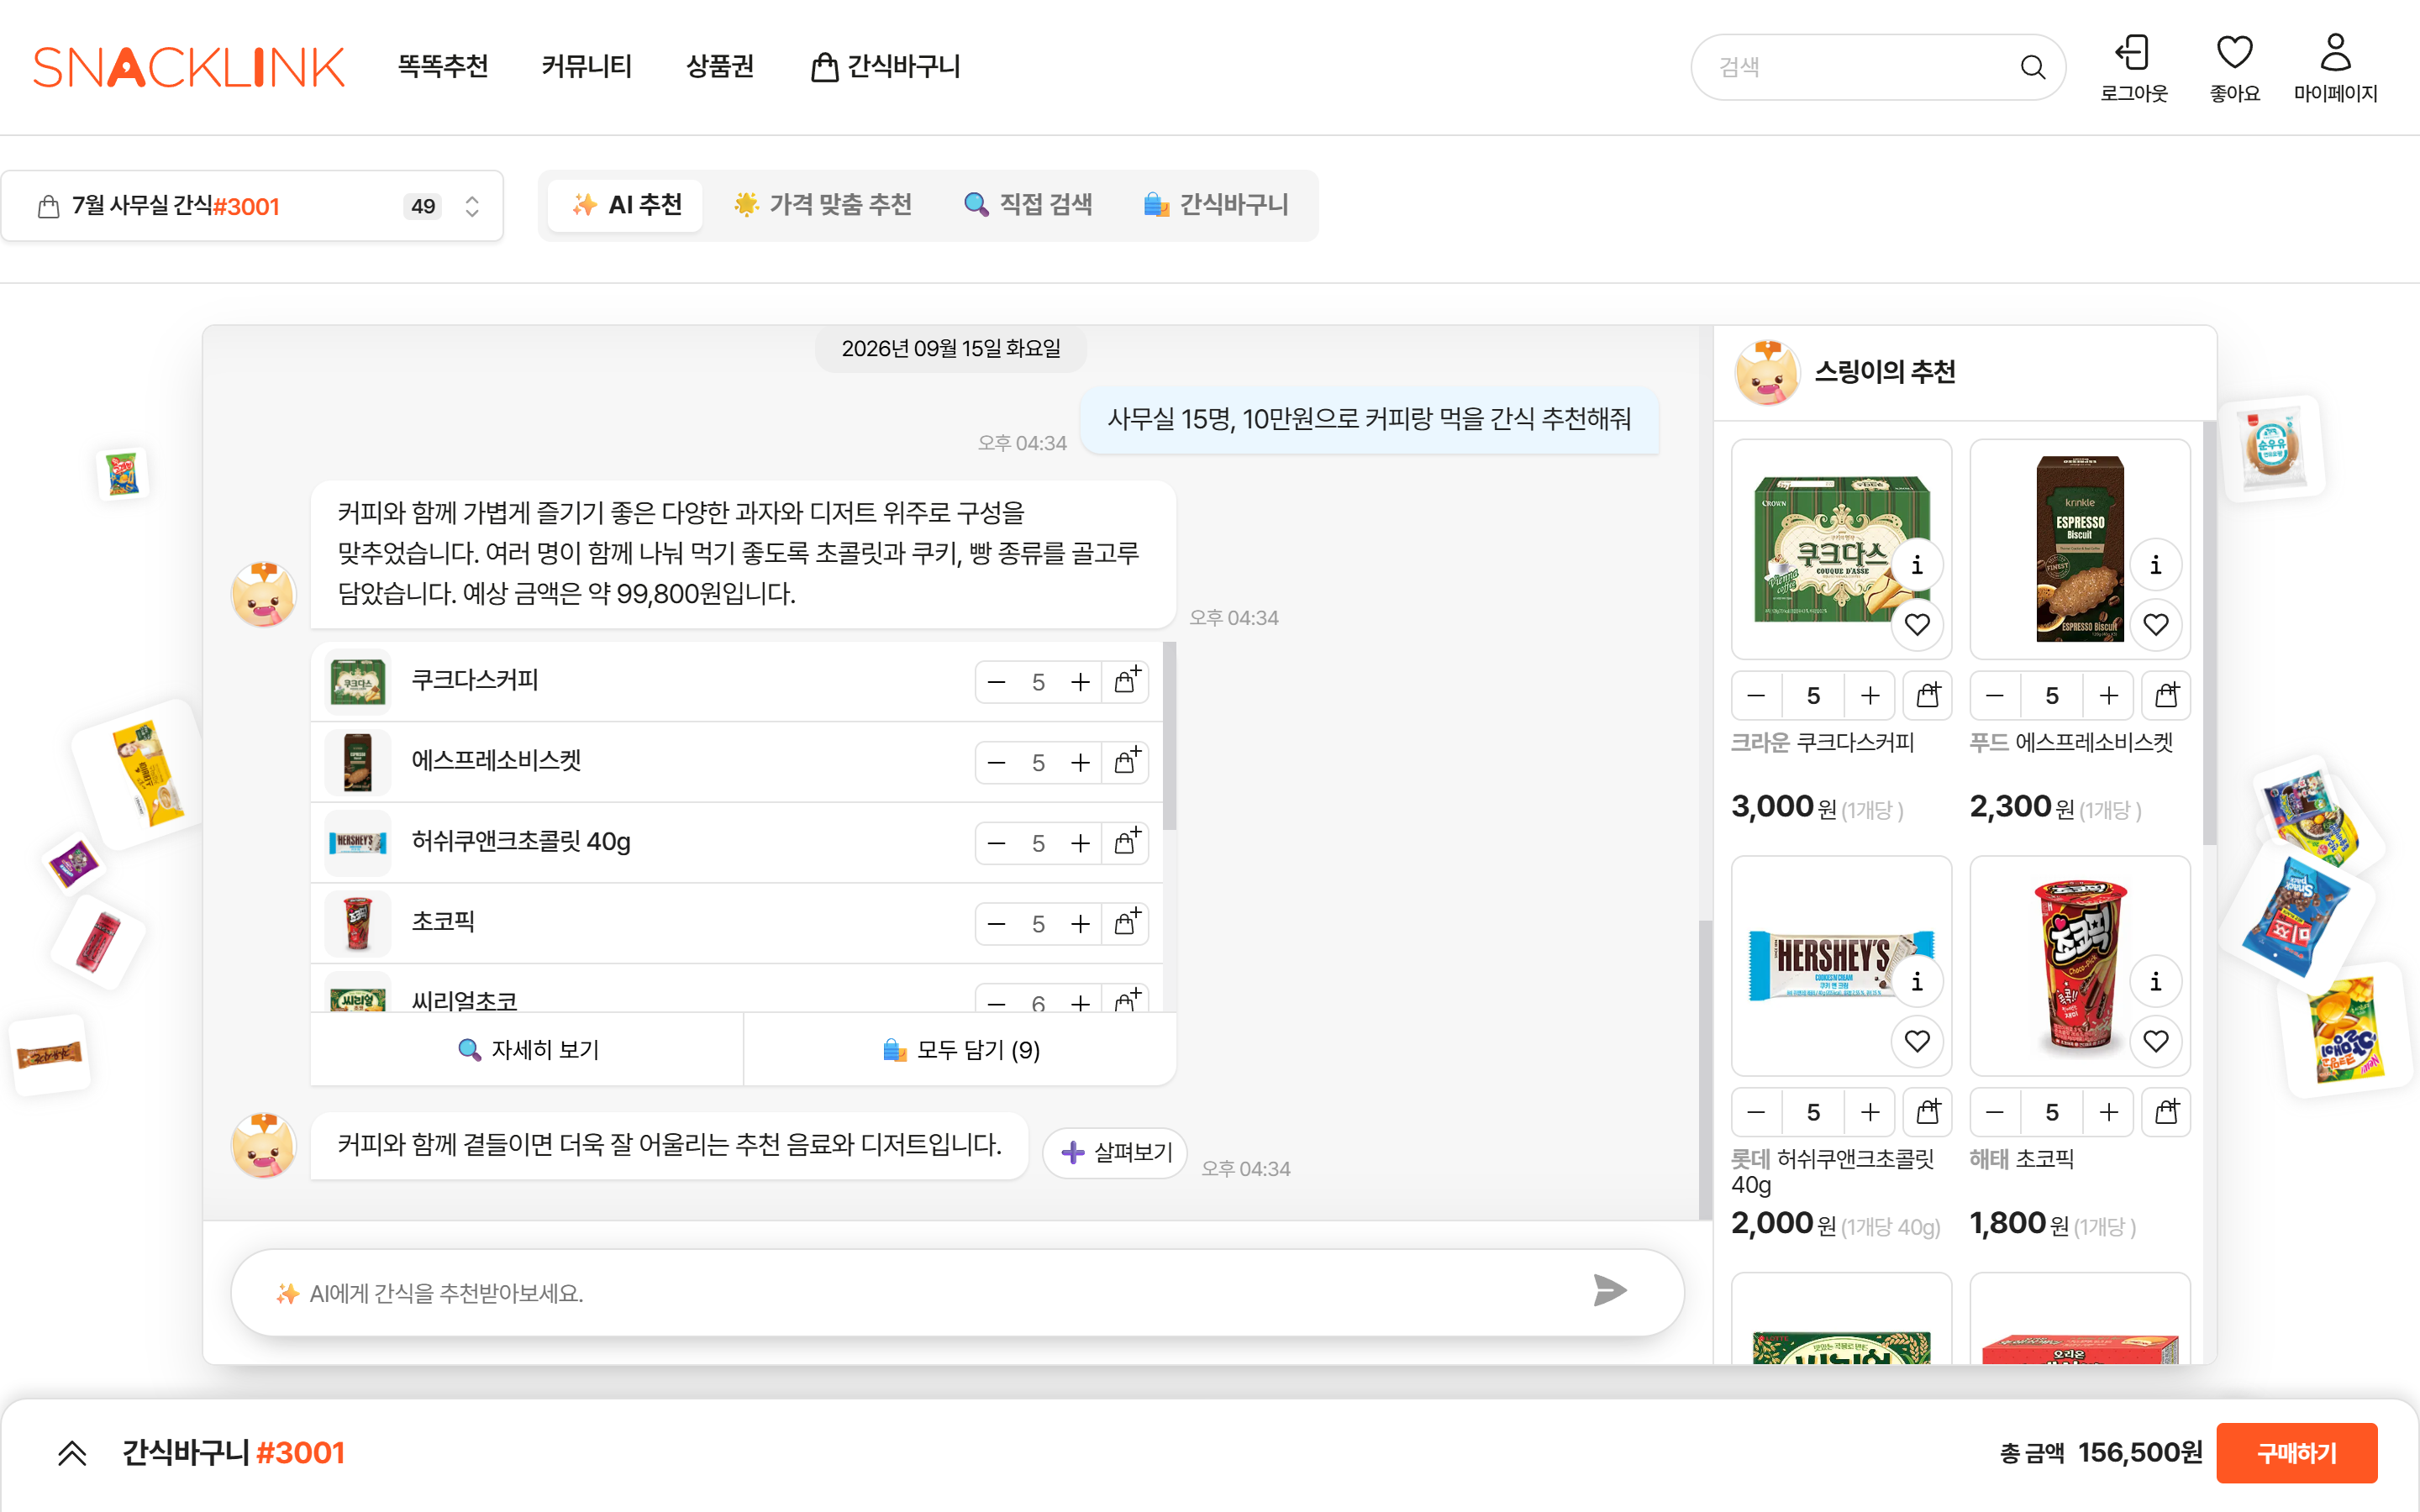
글에 실린 화면은 서비스 종료 후 만든 데모에서 다시 찍었습니다. UI는 원래 코드 그대로지만, 화면 속 답변 문장은 GPT가 아닌 데모용 모델이 만든 것입니다.
화면이 먼저 나왔습니다
챗 화면은 GPT가 붙기 전에 먼저 만들었습니다. 2024년 10월 말, 백엔드에 아직 아무것도 없을 때 더미 데이터로 시작했어요.
1export const SAMPLE_DATA = [
2  {
3    id: 11123,
4    input_text: '신상위주의 과자를 추천해주세요.',
5    output_text: '신상위주의 과자를 추천해드릴게요.',
6    snack_list: [...SNACK_LIST],
7    // ...
8  },
9];
AI가 뭐라고 답할지는 몰라도, 답에 무엇이 들어올지는 미리 정할 수 있었습니다. 설명 문장 하나와 상품 목록이요. 나중에 곁들이면 좋은 상품이 추가되면서 응답 모양은 이렇게 굳어졌습니다.
1interface iChatResponse {
2  message: string;              // AI가 쓴 설명
3  snack_list: iChatSnack[];     // 추천 상품 (수량·가격 포함)
4  recommend_message?: string;   // "이런 간식은 어떠세요?"
5  recommend_list?: iChatSnack[];// 곁들임 추천
6}
이 모양만 지켜지면 뒤에서 GPT가 어떻게 바뀌든 화면은 그대로 둘 수 있었어요. 실제로 백엔드는 이후 몇 번이나 방식이 바뀌었는데, 프론트는 거의 손대지 않았습니다.
백엔드가 LLM을 부르는 구조
처음부터 이런 구조였습니다. 프론트엔드(챗 화면)는 LLM API(OpenAI)를 직접 부르지 않고 백엔드(Django)에만 요청합니다. LLM API를 부르고 그 결과를 가공해서 돌려주는 건 백엔드의 일입니다.
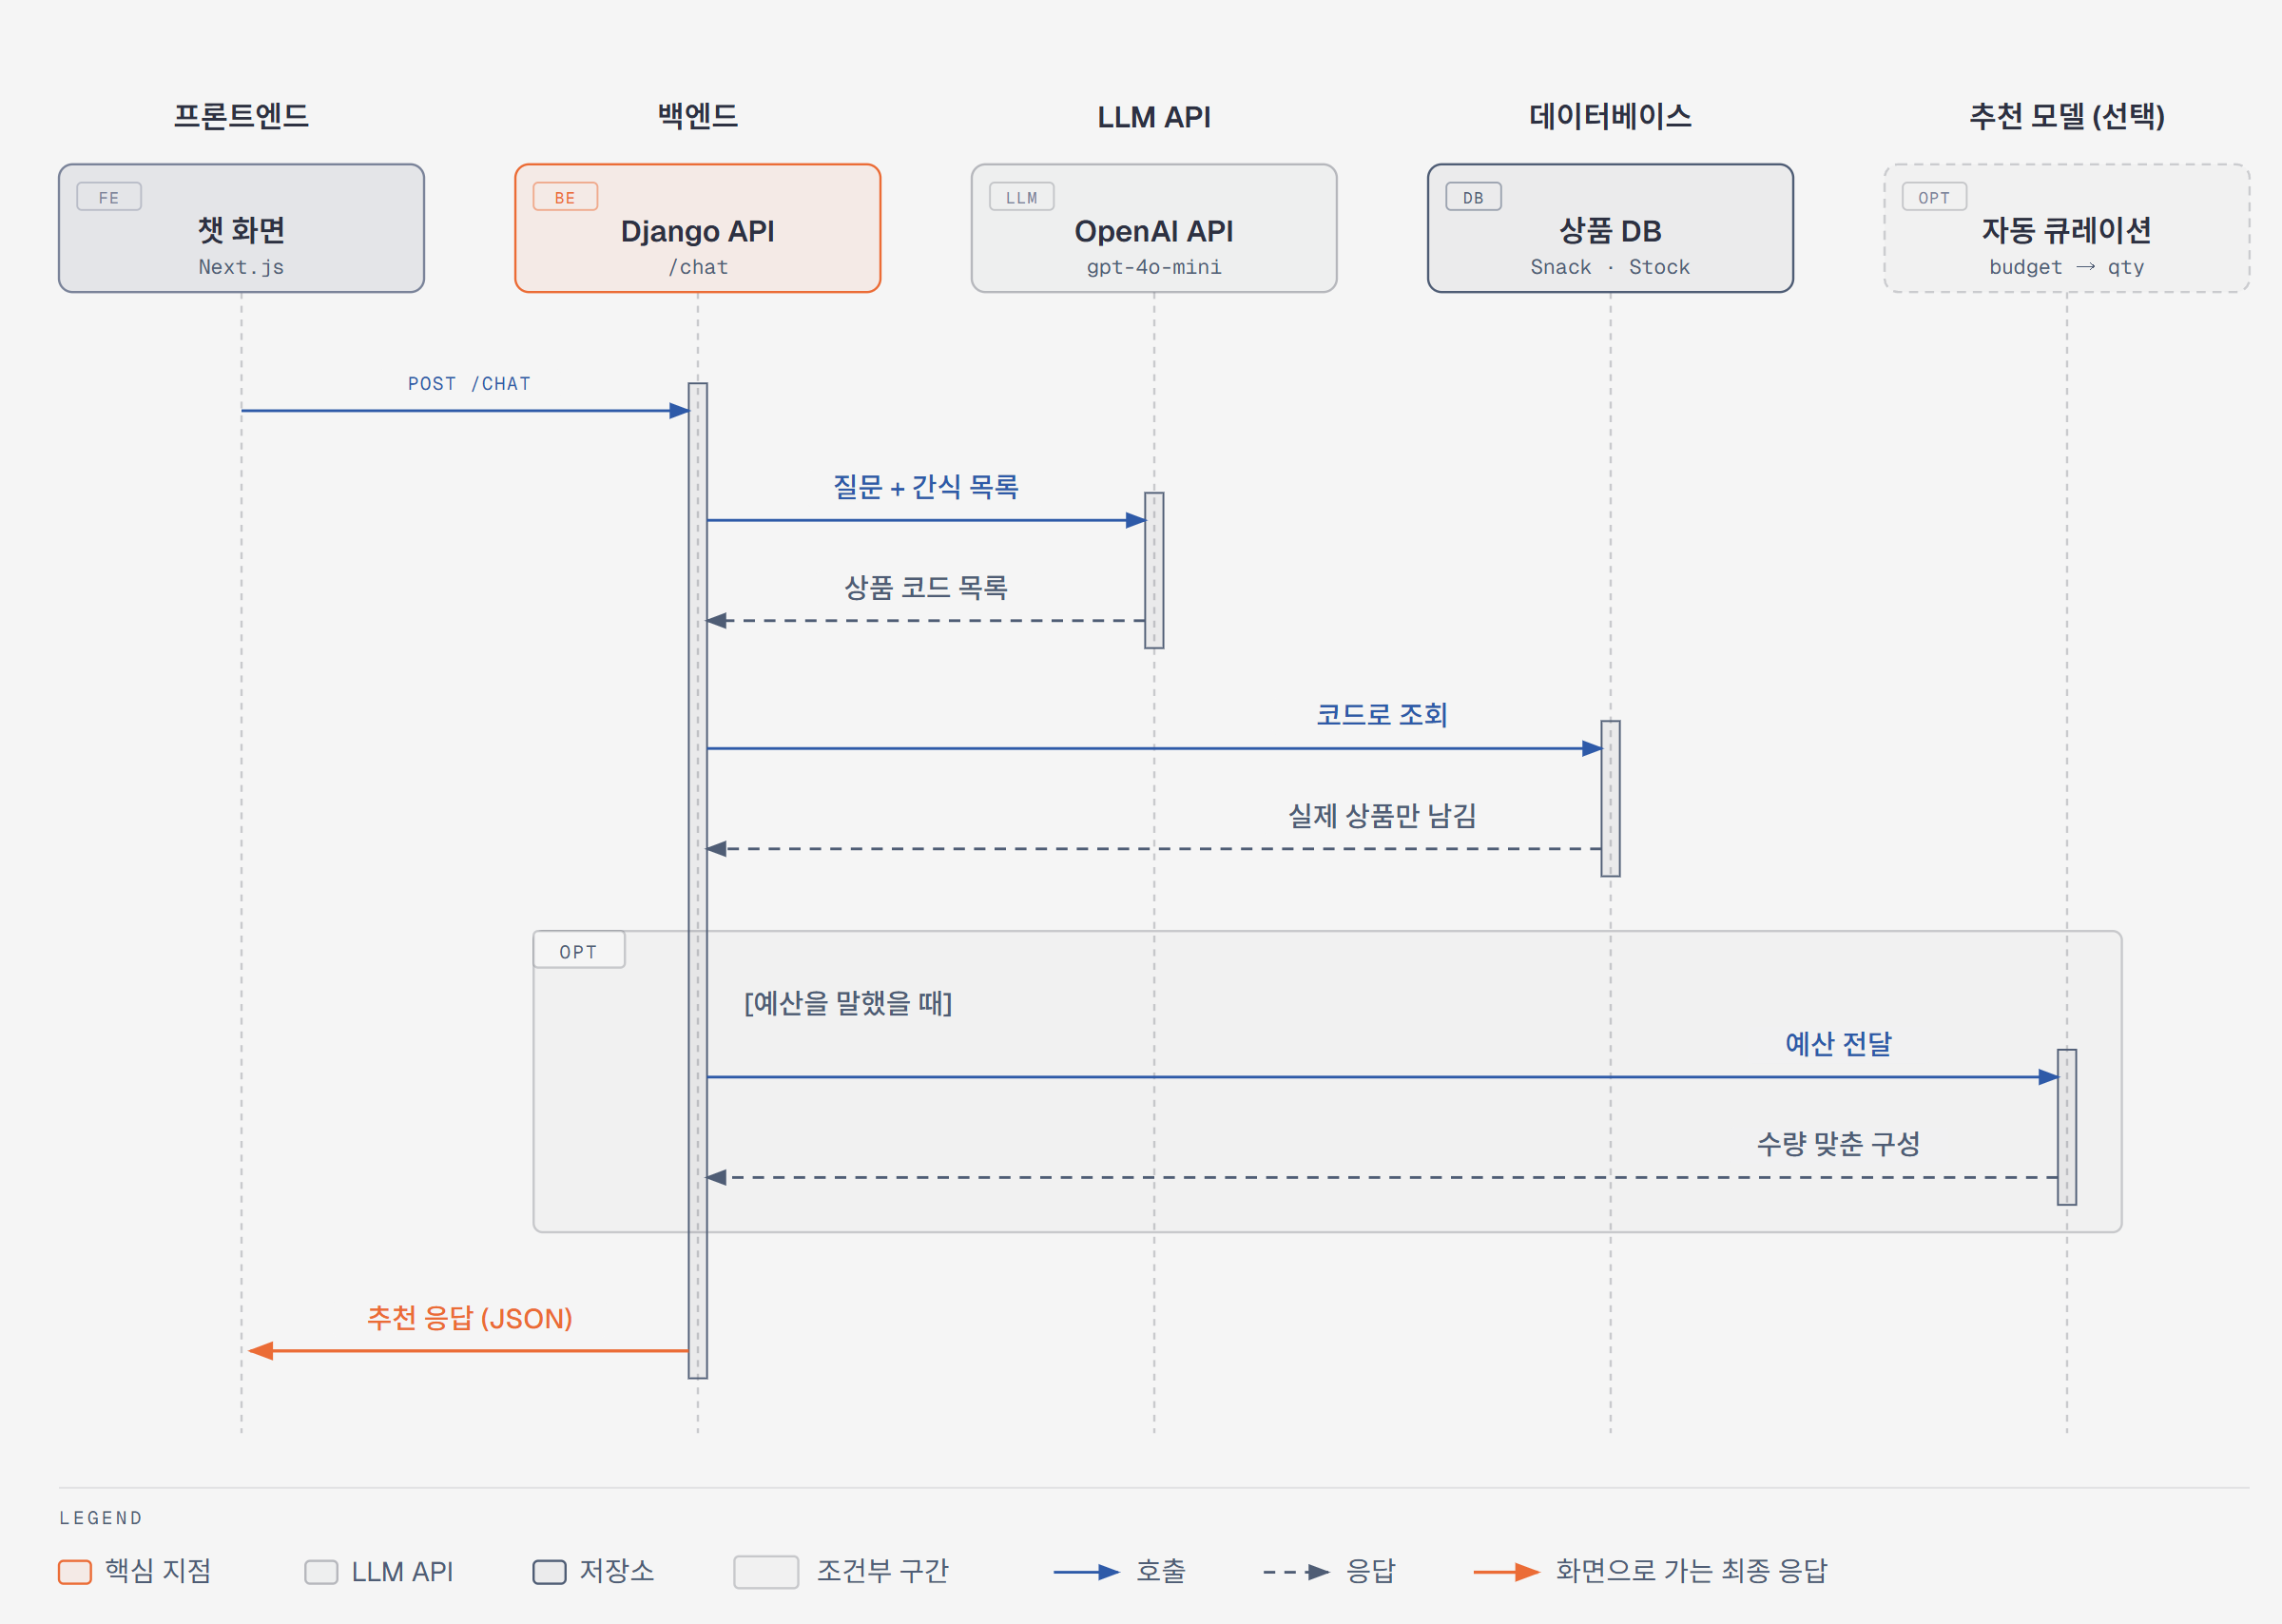
LLM이 주는 건 상품 코드와 설명 문장뿐이고, 상품 이름, 이미지, 가격, 재고는 전부 우리 DB에서 옵니다. 예산을 말하면 회사에 있던 자동 큐레이션 모델에 예산을 넘겨 수량을 맞췄고요. 이 구조가 왜 중요했는지는 바로 다음에 나옵니다.
없는 간식을 추천한다
사전 프롬프트는 역할을 정해 주는 데서 시작했습니다.
# 역할
- 당신은 Json을 반환하는 Assistant이자, 스낵을 추천할 수 있는 전문가입니다.
그리고 판매 중인 간식 목록을 JSON 파일(snack_list.json)로 OpenAI에 올려 두고, 그 파일에서 골라 상품 코드와 이름을 돌려달라고 했습니다.
근데 이런 간식이 있었나?
할루시네이션이 생각보다 심했습니다. 목록에 없는 간식을 그럴듯한 이름으로 만들어서 추천하기도 했어요. 사용자가 "모두 담기"를 눌렀는데 없는 상품이 섞여 있으면, 챗 하나가 아니라 서비스 전체를 못 믿게 됩니다.
그래서 두 겹으로 막았습니다.
첫 번째는 프롬프트. 11월 말부터 프롬프트에 이런 줄이 들어갔습니다.
1# 필수 조건
2- code, name3 가 정확히 있는 상품만 선정.
3- 과자를 추천해 달라는 의미가 들어가 있다면 category1은 과자인 상품만 선정.
4- 절대 만들어내서는 안됨. 절대 안됨.
"절대 안됨"을 두 번 쓴 데서 당시 분위기가 느껴지네요. 12월에는 조금 더 구체적으로 바뀝니다.
- snack_list.json 파일에서만 추천합니다. code와 name3는 생성하면 안됩니다. 파일안에서만 추천합니다.두 번째는 백엔드 검증. 프롬프트를 아무리 세게 써도 확률을 낮출 뿐, 0으로 만들지는 못합니다. 그래서 모델이 준 상품 코드를 DB에 다시 물어봤어요.
1code_list = [row["code"] for row in result_dict["snack_list"]]
2snack_list = Snack.objects.filter(
3    code__in=code_list, is_activate=True, main_stock__warehouse="메인", main_stock__current_qt__gte=1,
4)
코드가 실제로 있는지, 판매 중인지, 재고가 있는지까지 한 번에 거릅니다. 모델이 지어낸 상품은 여기서 그냥 사라지고, 화면에는 실제로 주문할 수 있는 상품만 나갑니다. 가격도 모델이 아니라 DB가 계산한 값이 붙고요.
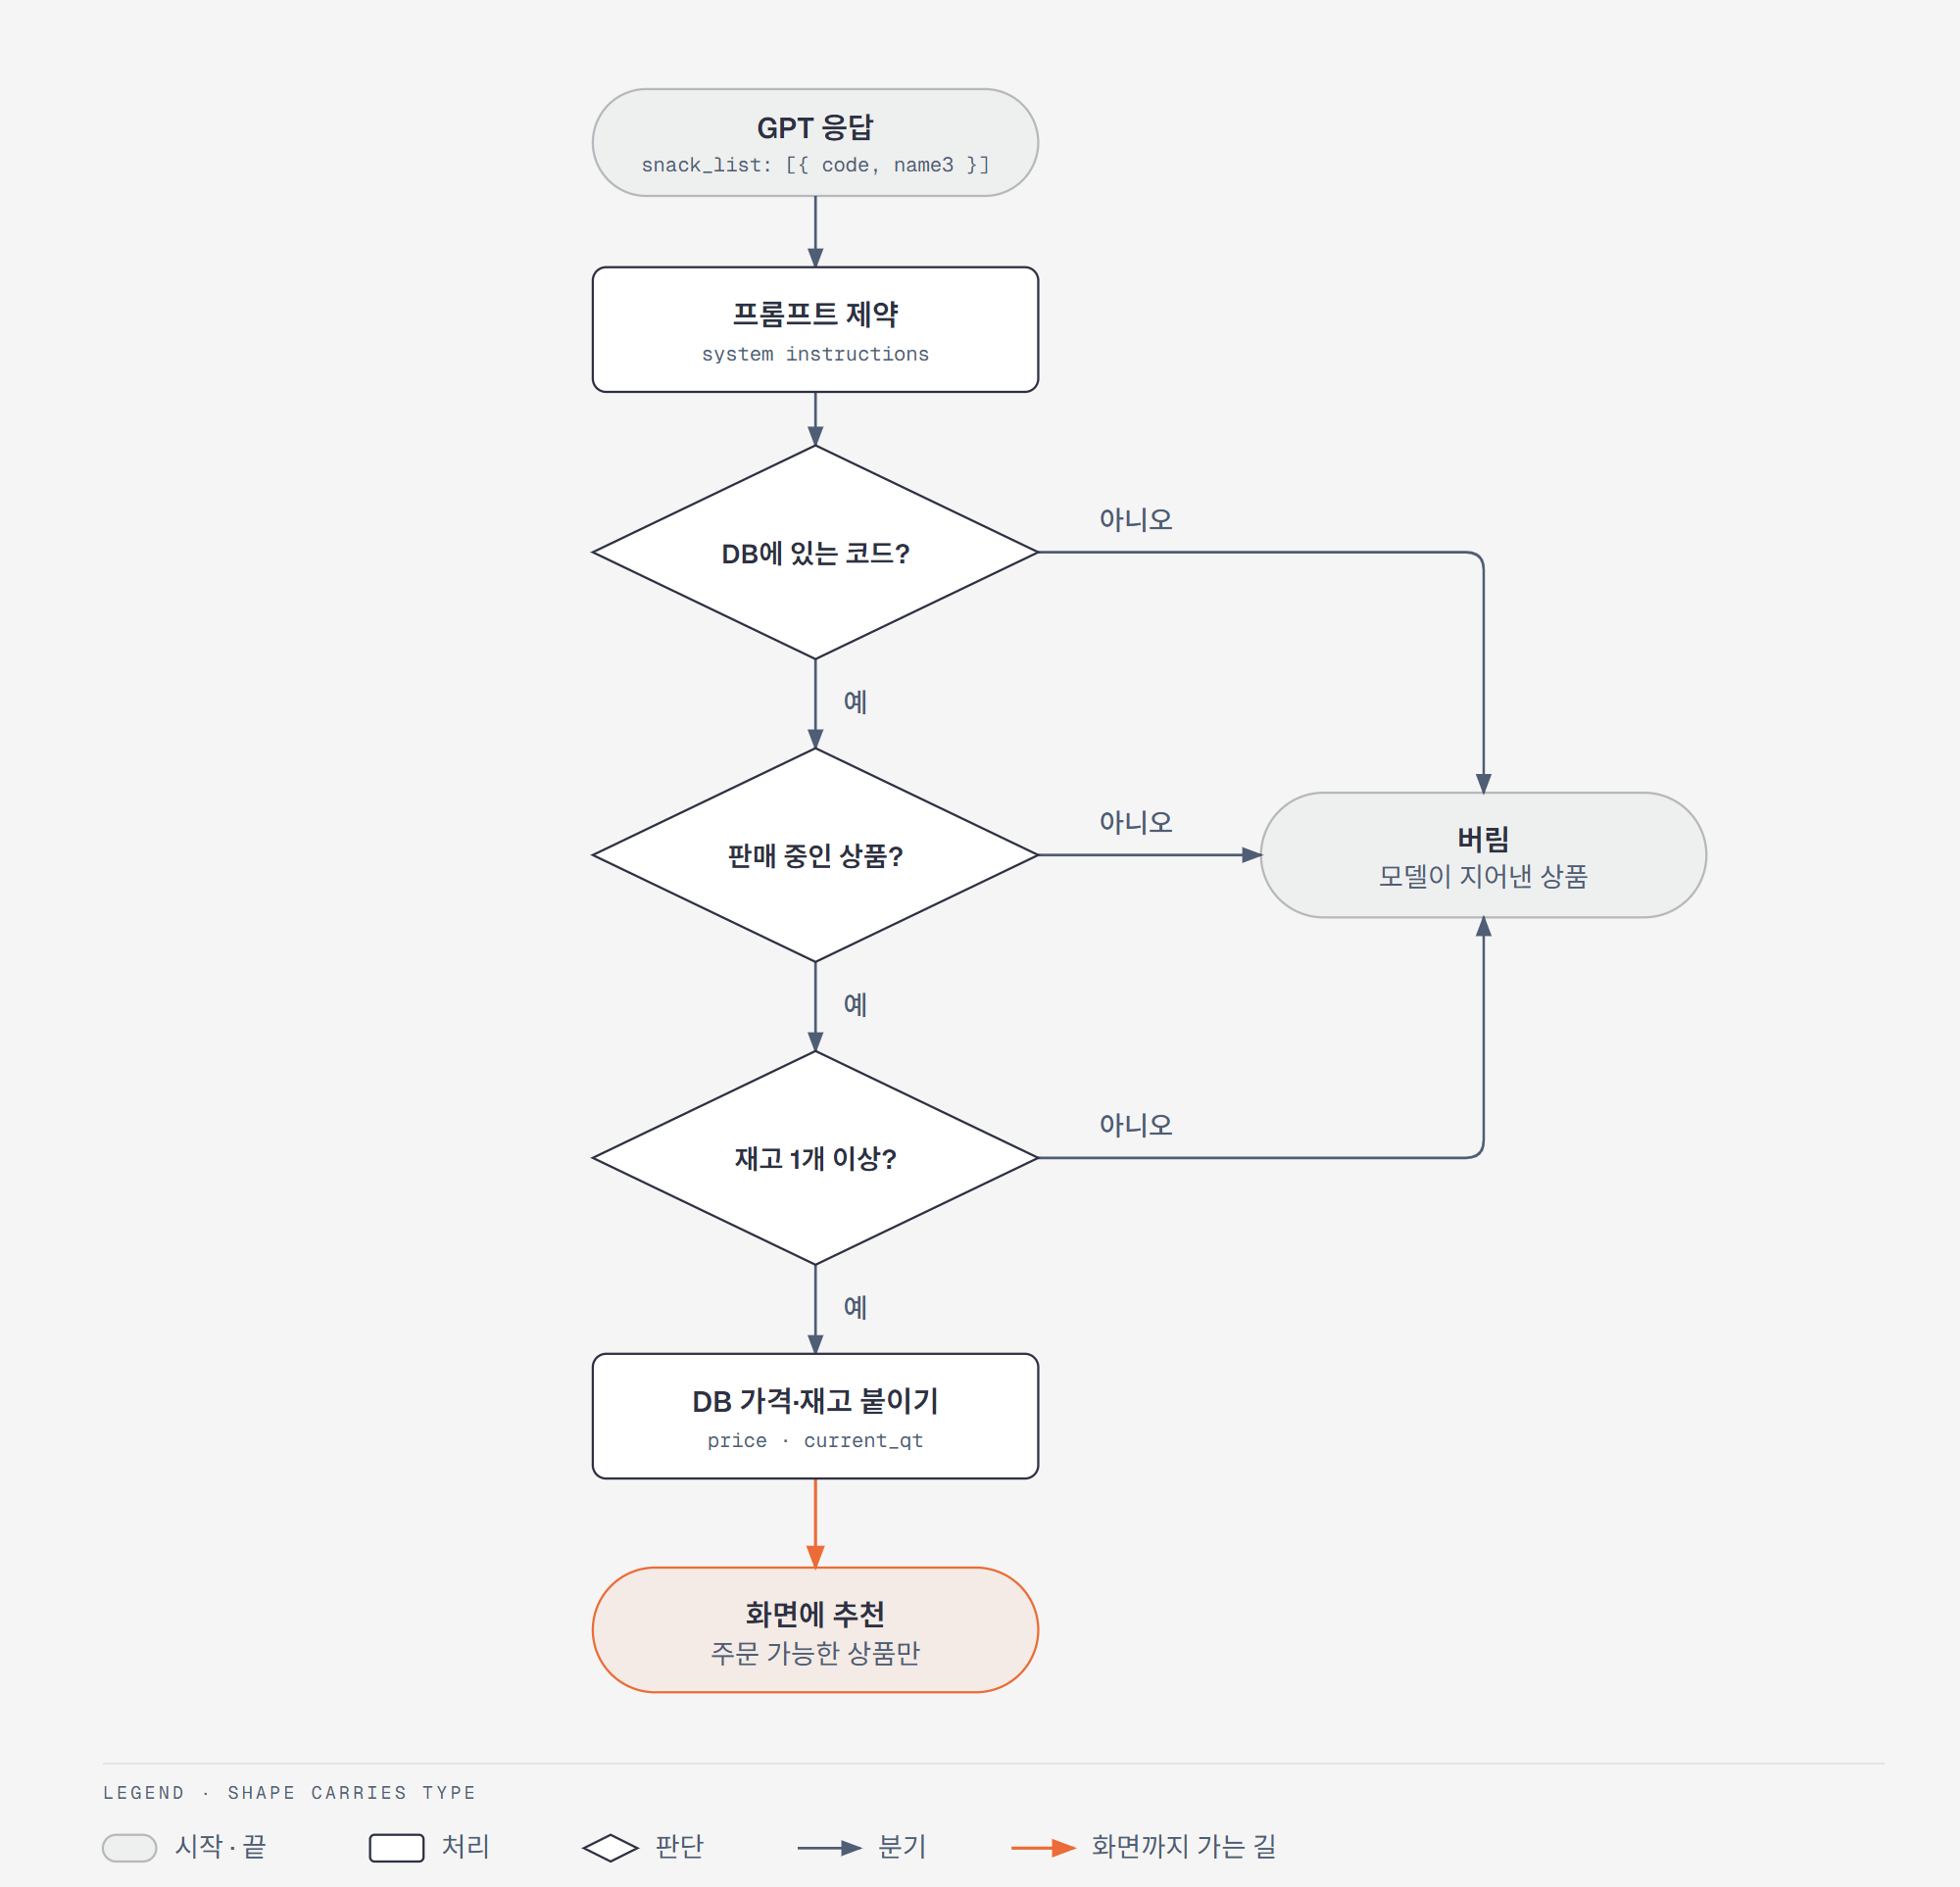
이 두 겹을 넣고 나서 추천 결과를 믿을 수 있게 됐고, 서비스 신뢰도도 확실히 올라갔습니다. 프롬프트는 이상한 답이 나올 확률을 낮추고, 검증은 이상한 답이 사용자에게 닿지 않게 합니다. 둘 중 하나만으로는 부족했어요.
참고로 백엔드는 이 방식 전에 다른 접근도 시도했습니다. GPT에게 상품을 직접 고르게 하지 않고, 질문에서 조건만 뽑게 하는 방식이었어요. 카테고리, 맛, 예산, 포장 형태 같은 걸 미리 준 목록 안에서만 고르게 하고, 실제 상품 검색은 DB 쿼리가 하는 식입니다. 없는 상품이 나올 수가 없는 구조라 안전한 방식이었죠. 왜 바꿨는지는 백엔드 쪽 사정이라 자세히는 모르지만, 결국 목록을 주고 직접 고르게 한 뒤 검증하는 쪽으로 정리됐어요. 응답 모양이 그대로라 프론트는 따라 바꿀 게 없었습니다.
기다리는 시간 채우기
여기서부터가 제가 한 일입니다.
GPT 응답은 금방 오지 않았습니다. 백엔드가 OpenAI에 요청을 넣고 처리가 끝날 때까지 기다린 다음 DB 검증까지 하니까, 몇 초씩 걸리는 게 보통이었어요. 그 몇 초 동안 화면이 멈춰 있으면 사용자는 고장 난 줄 압니다.
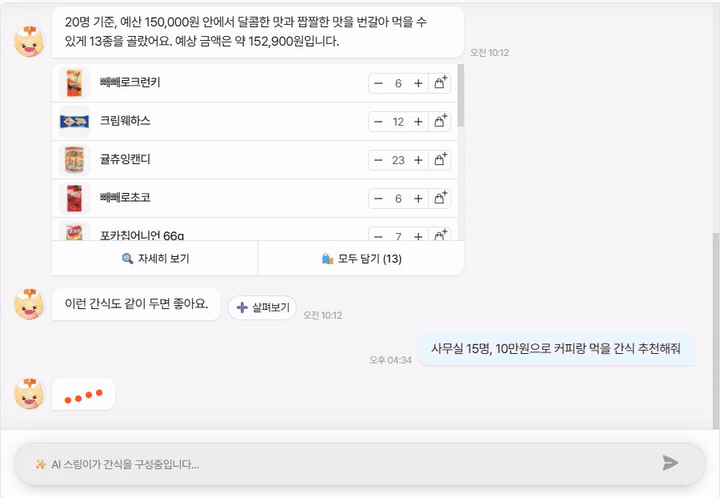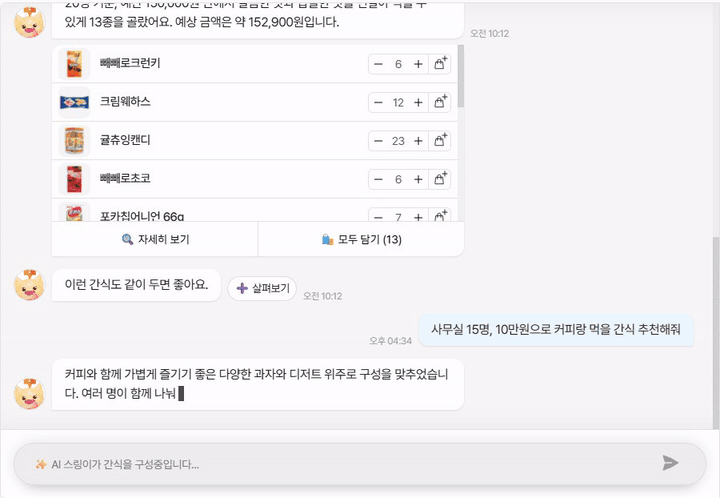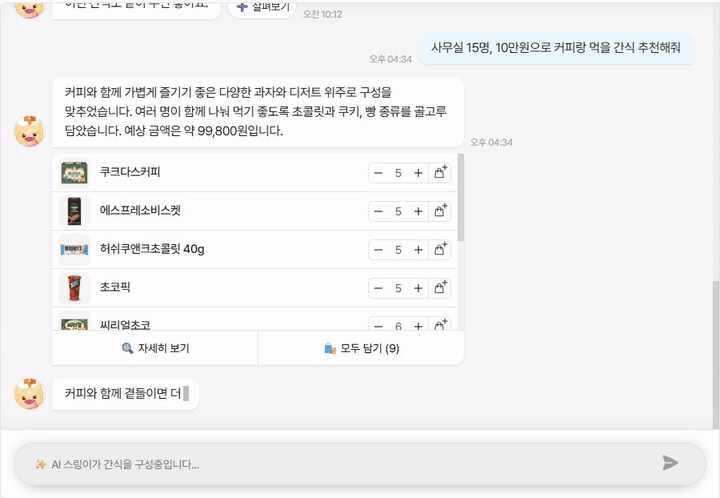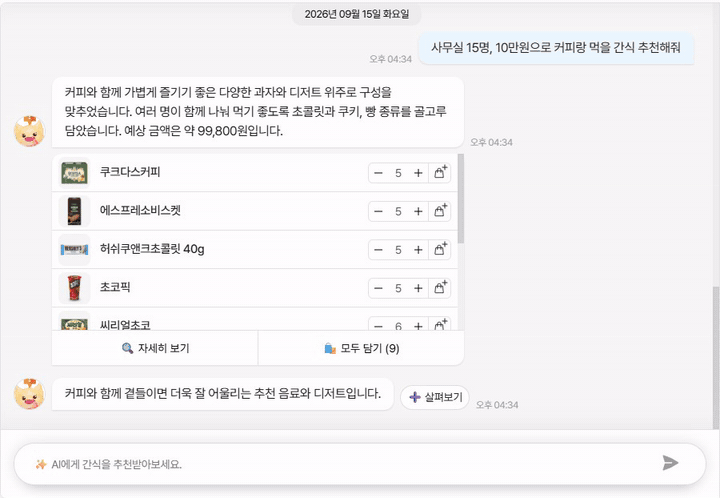
그래서 응답 하나를 세 단계로 나눠 보여줬습니다.
1const initialState = {
2  inProgress: false,
3  p00apiLoading: false, // 1. 응답 기다리는 중 (로딩 점)
4  p01ongoing: false,    // 2. 추천 메시지 + 상품 목록
5  p02ongoing: false,    // 3. 곁들임 추천
6  // ...
7};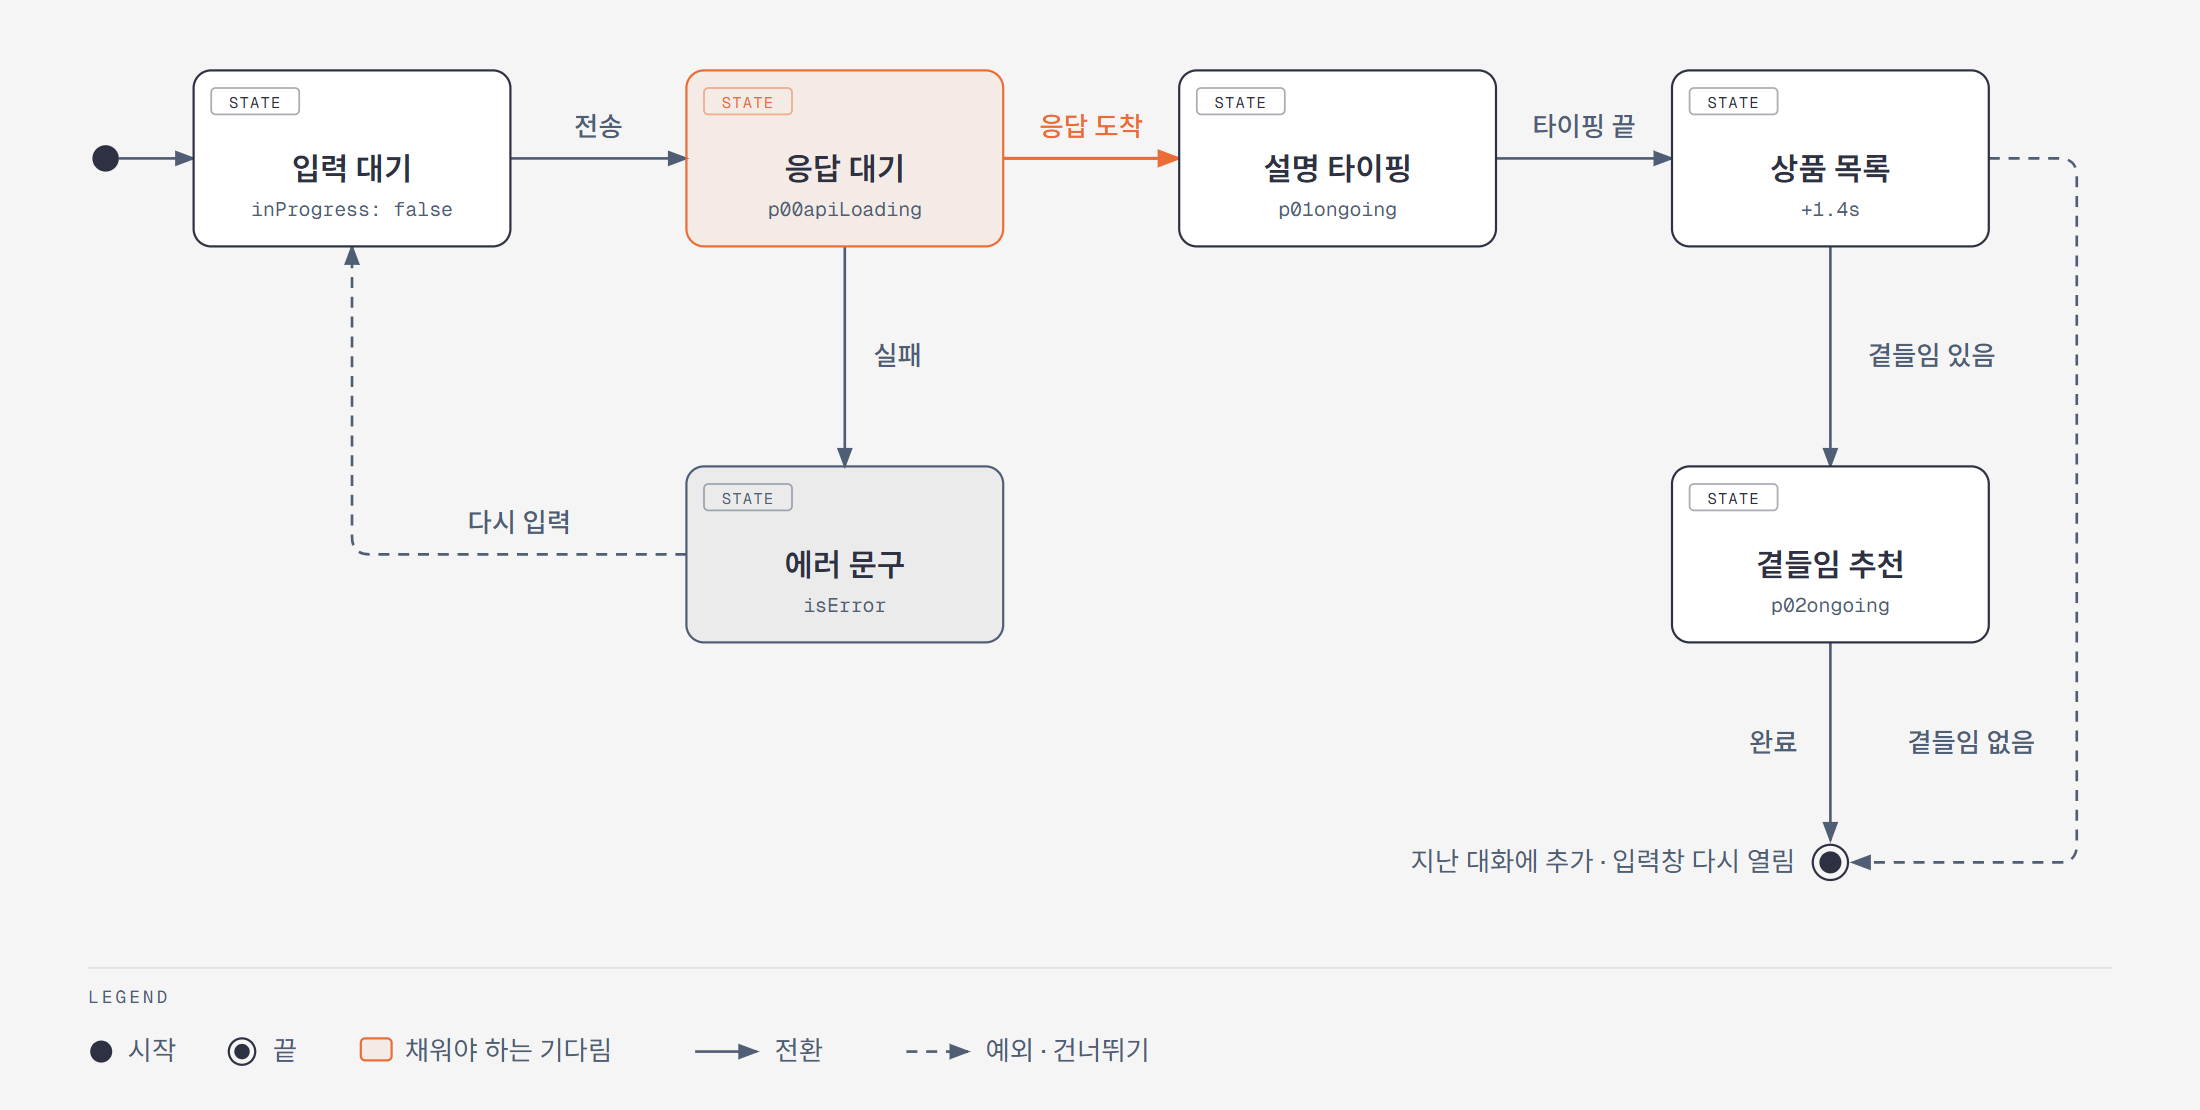
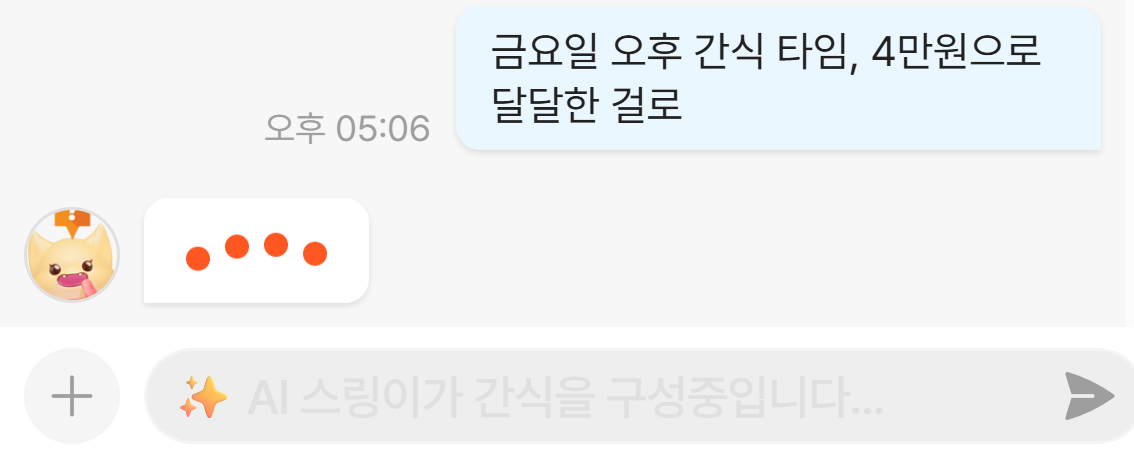
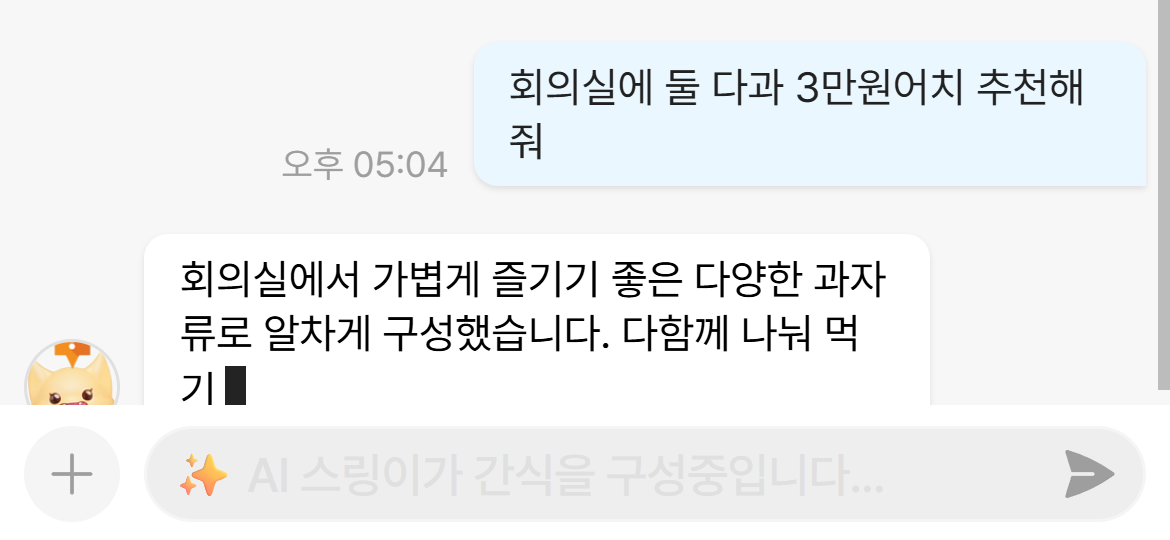
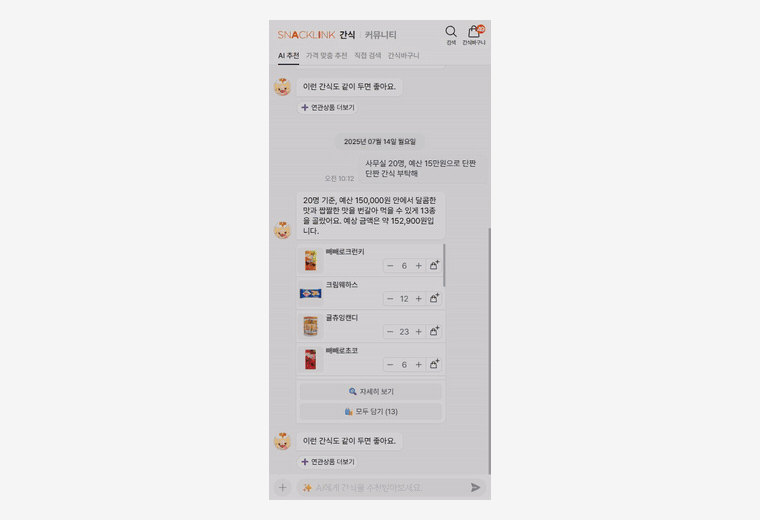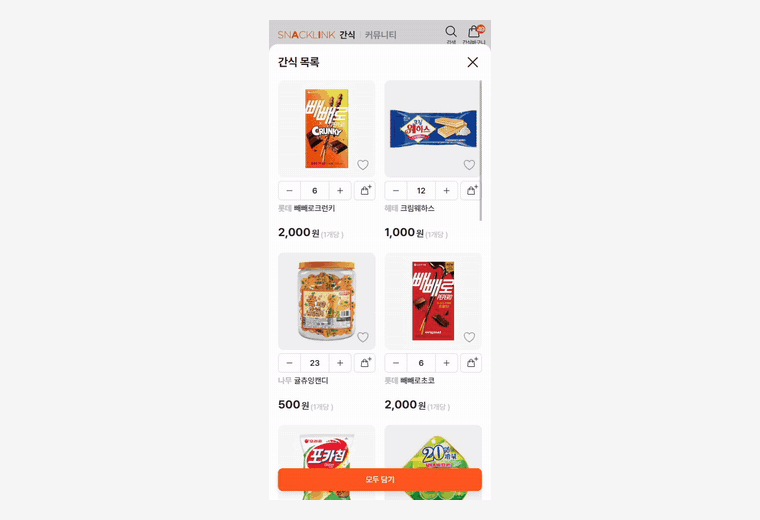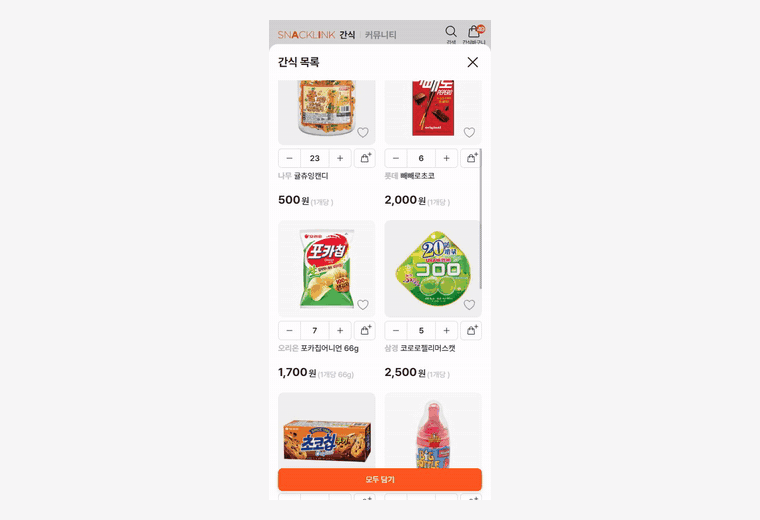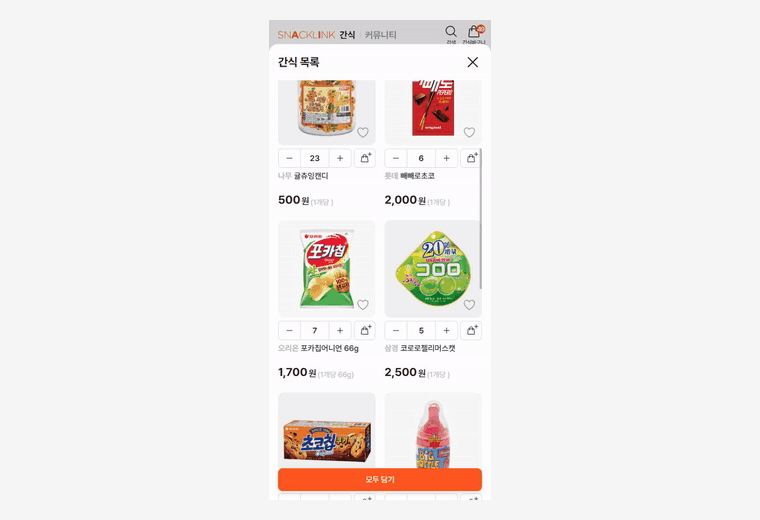
질문을 보내면 AI 캐릭터 '스링이'의 말풍선에 로딩 점이 뜨고, 입력창은 잠기면서 "AI 스링이가 간식을 구성중입니다..."로 바뀝니다. 응답이 오면 설명 문장이 한 글자씩 타이핑되고, 다 쳐지면 1.4초 뒤에 상품 목록이 나옵니다. 그다음 곁들임 추천이 같은 방식으로 한 번 더 이어지고요.
1const onChatDone = () => {
2  setChatStats(STATUS.DONE);
3  setListStats(STATUS.ONGOING);
4
5  setTimeout(() => {
6    onListDone(); // 목록까지 끝나면 다음 단계(곁들임 추천)로
7  }, 1400);
8};
타이핑 효과는 react-simple-typewriter를 썼습니다. 응답은 이미 다 받아 둔 상태라 사실 한 번에 보여줄 수도 있었는데, 일부러 천천히 풀었어요. 사람이랑 대화하는 느낌도 나고, 설명을 읽을 틈이 생겨야 바로 아래 상품 목록이 "왜 이게 나왔는지" 이해가 되거든요.
단계를 나눈 게 구현에서도 도움이 됐습니다. 각 말풍선이 끝나면 onCompleted로 다음 단계를 부르는 식이라, 곁들임 추천이 없는 응답이면 그 단계만 건너뛰면 됐어요.
답을 받으면 바로 담게
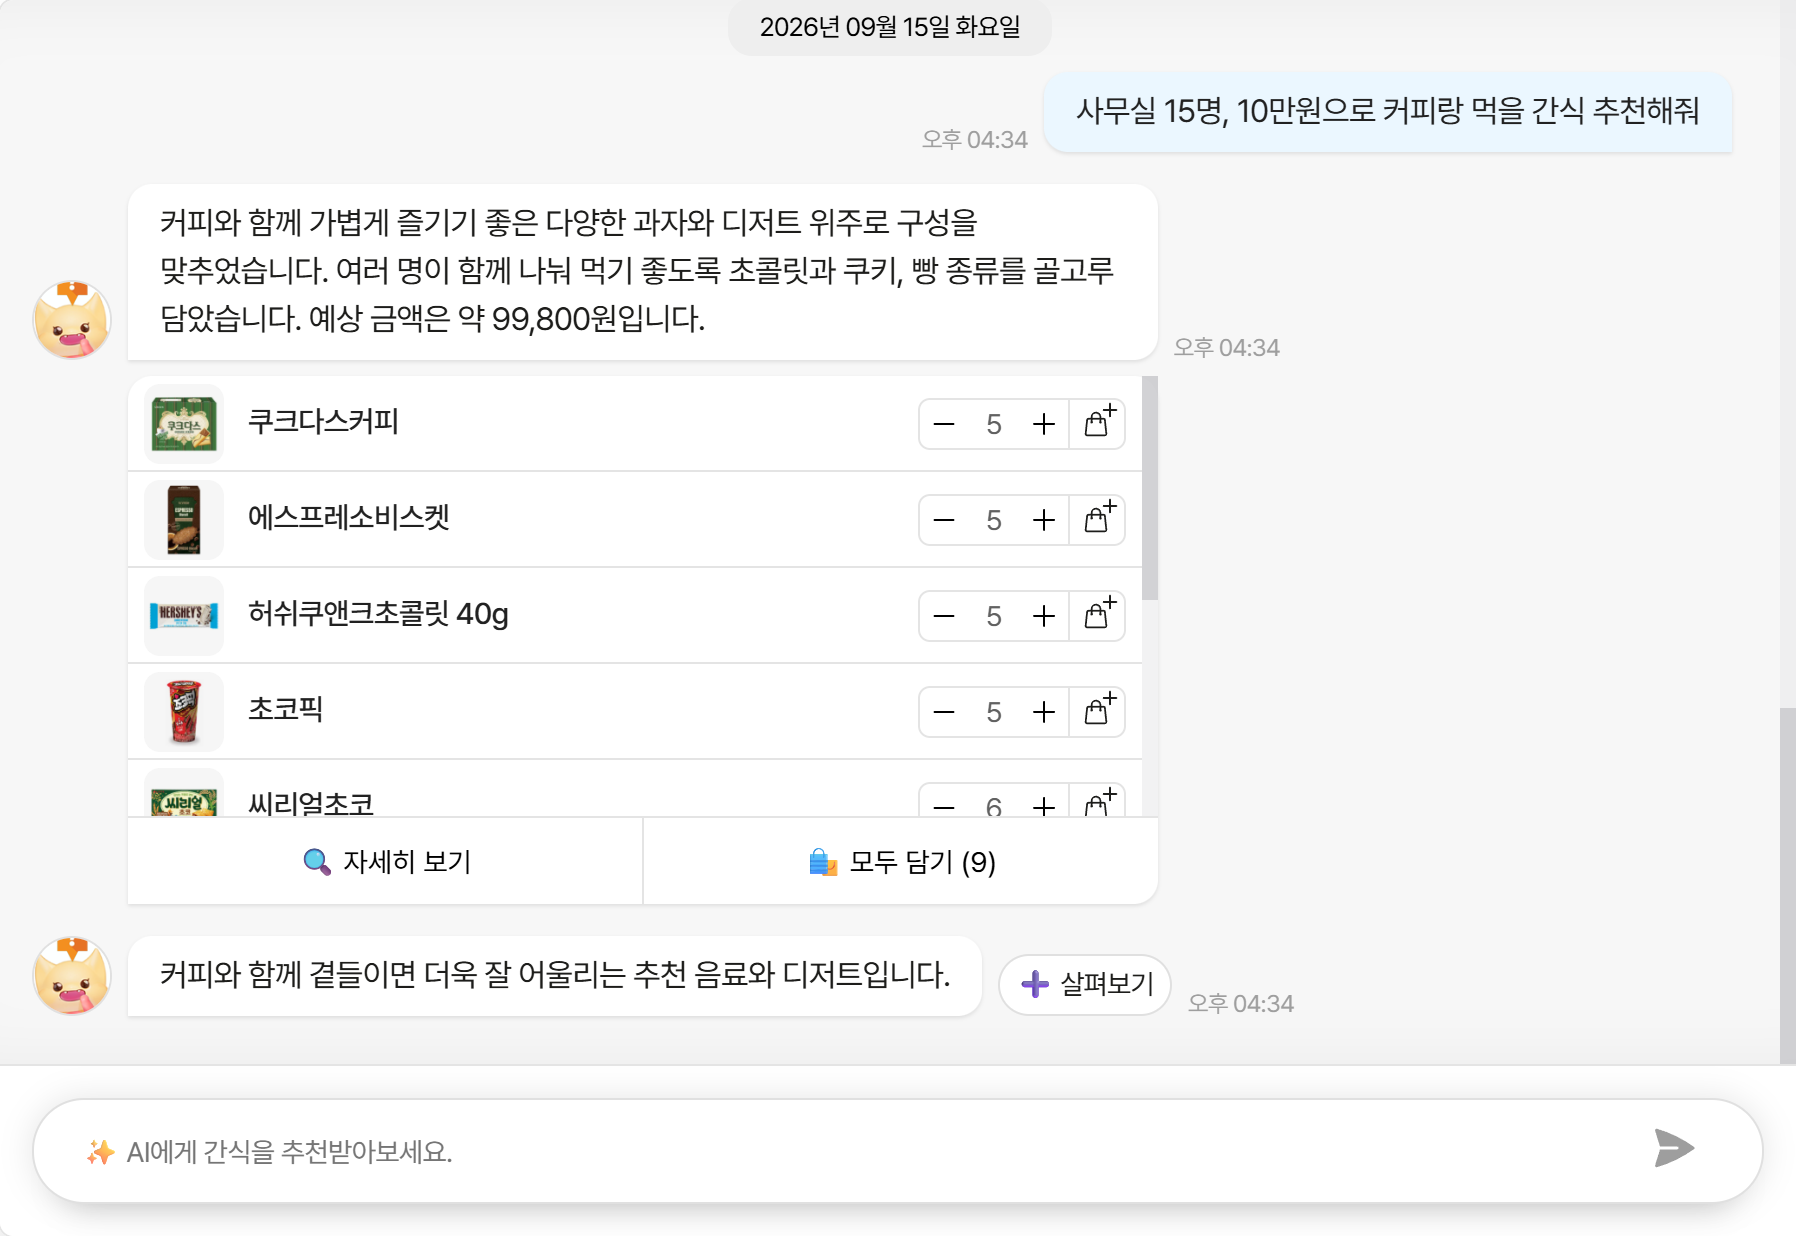
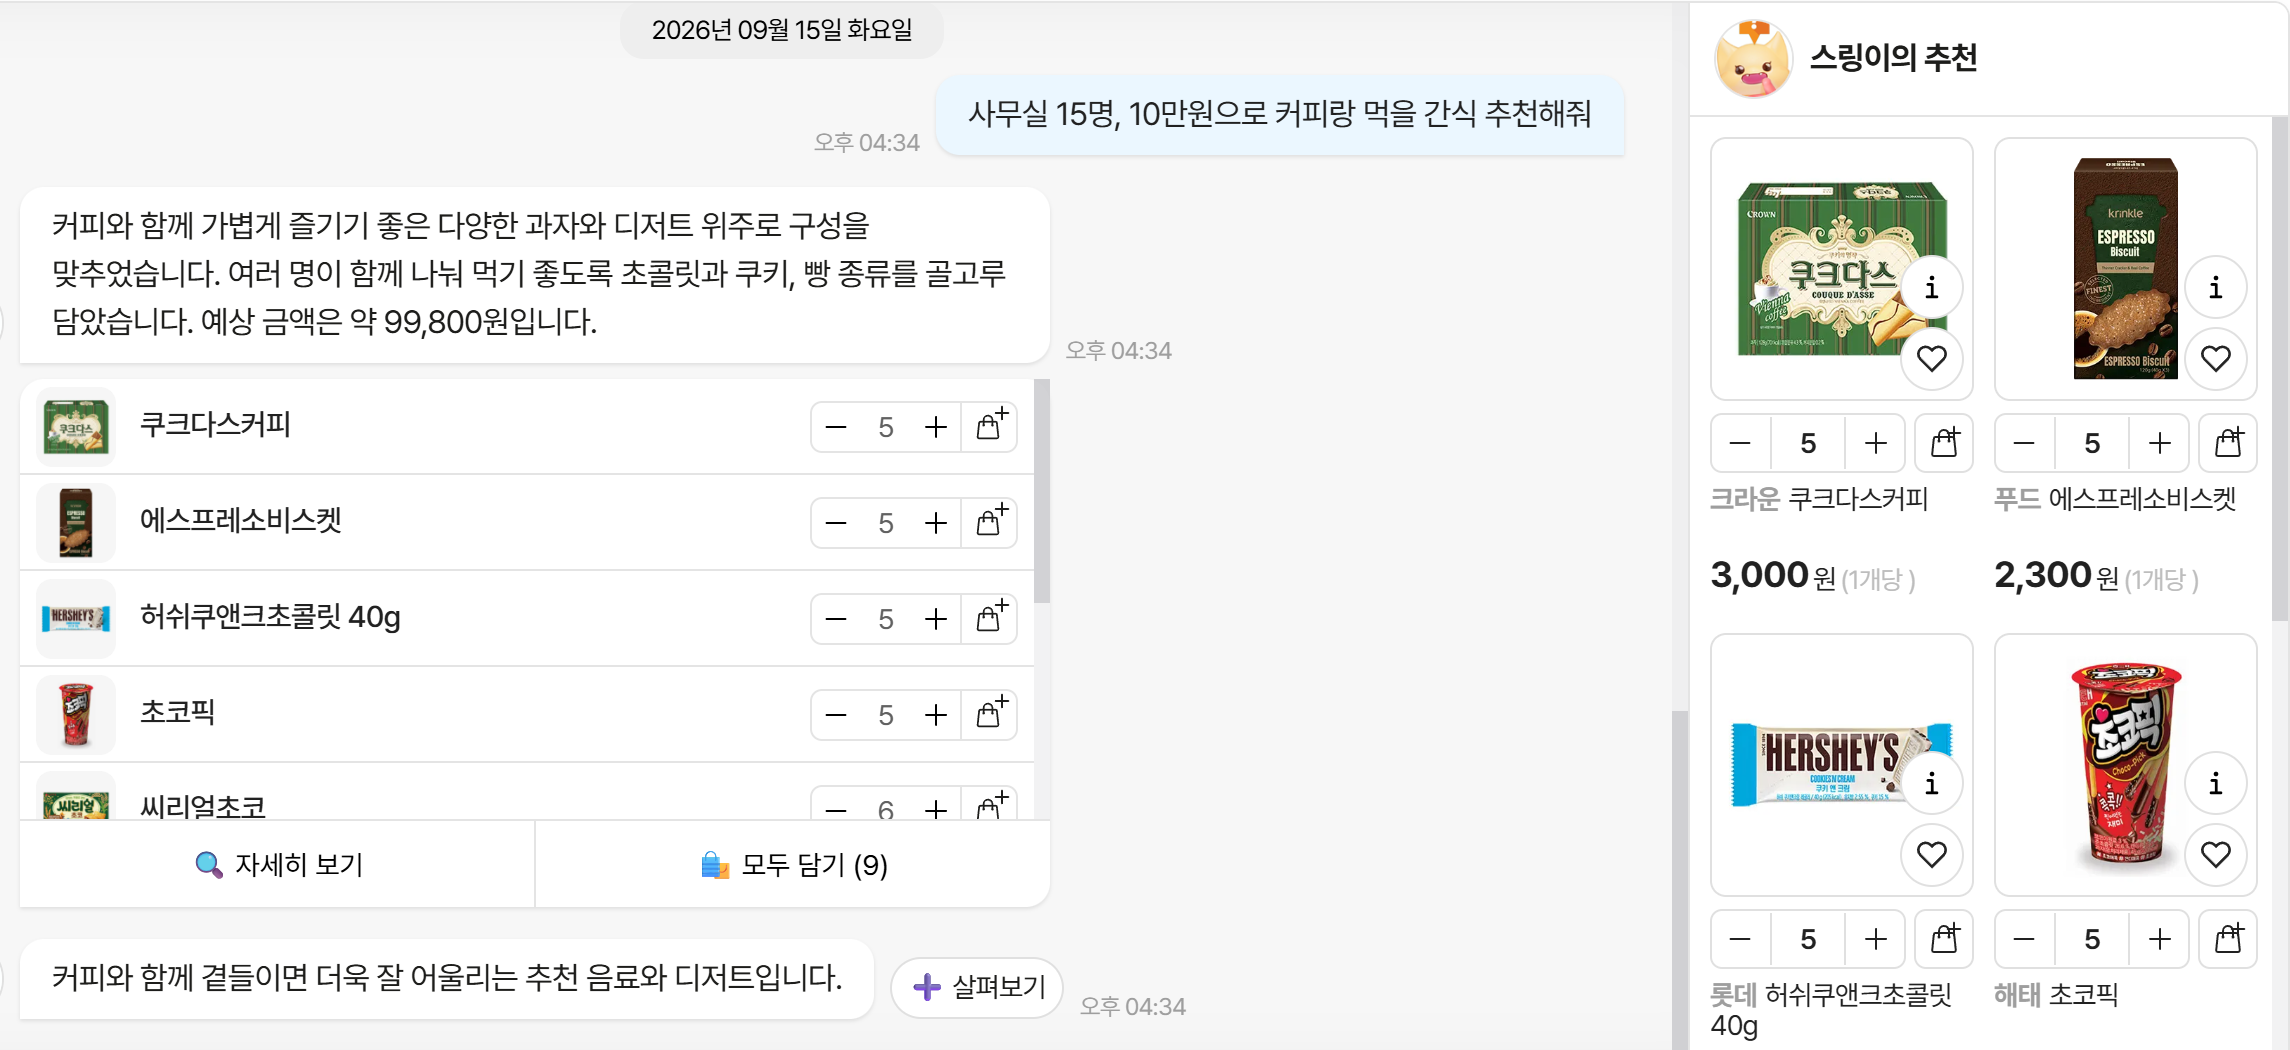
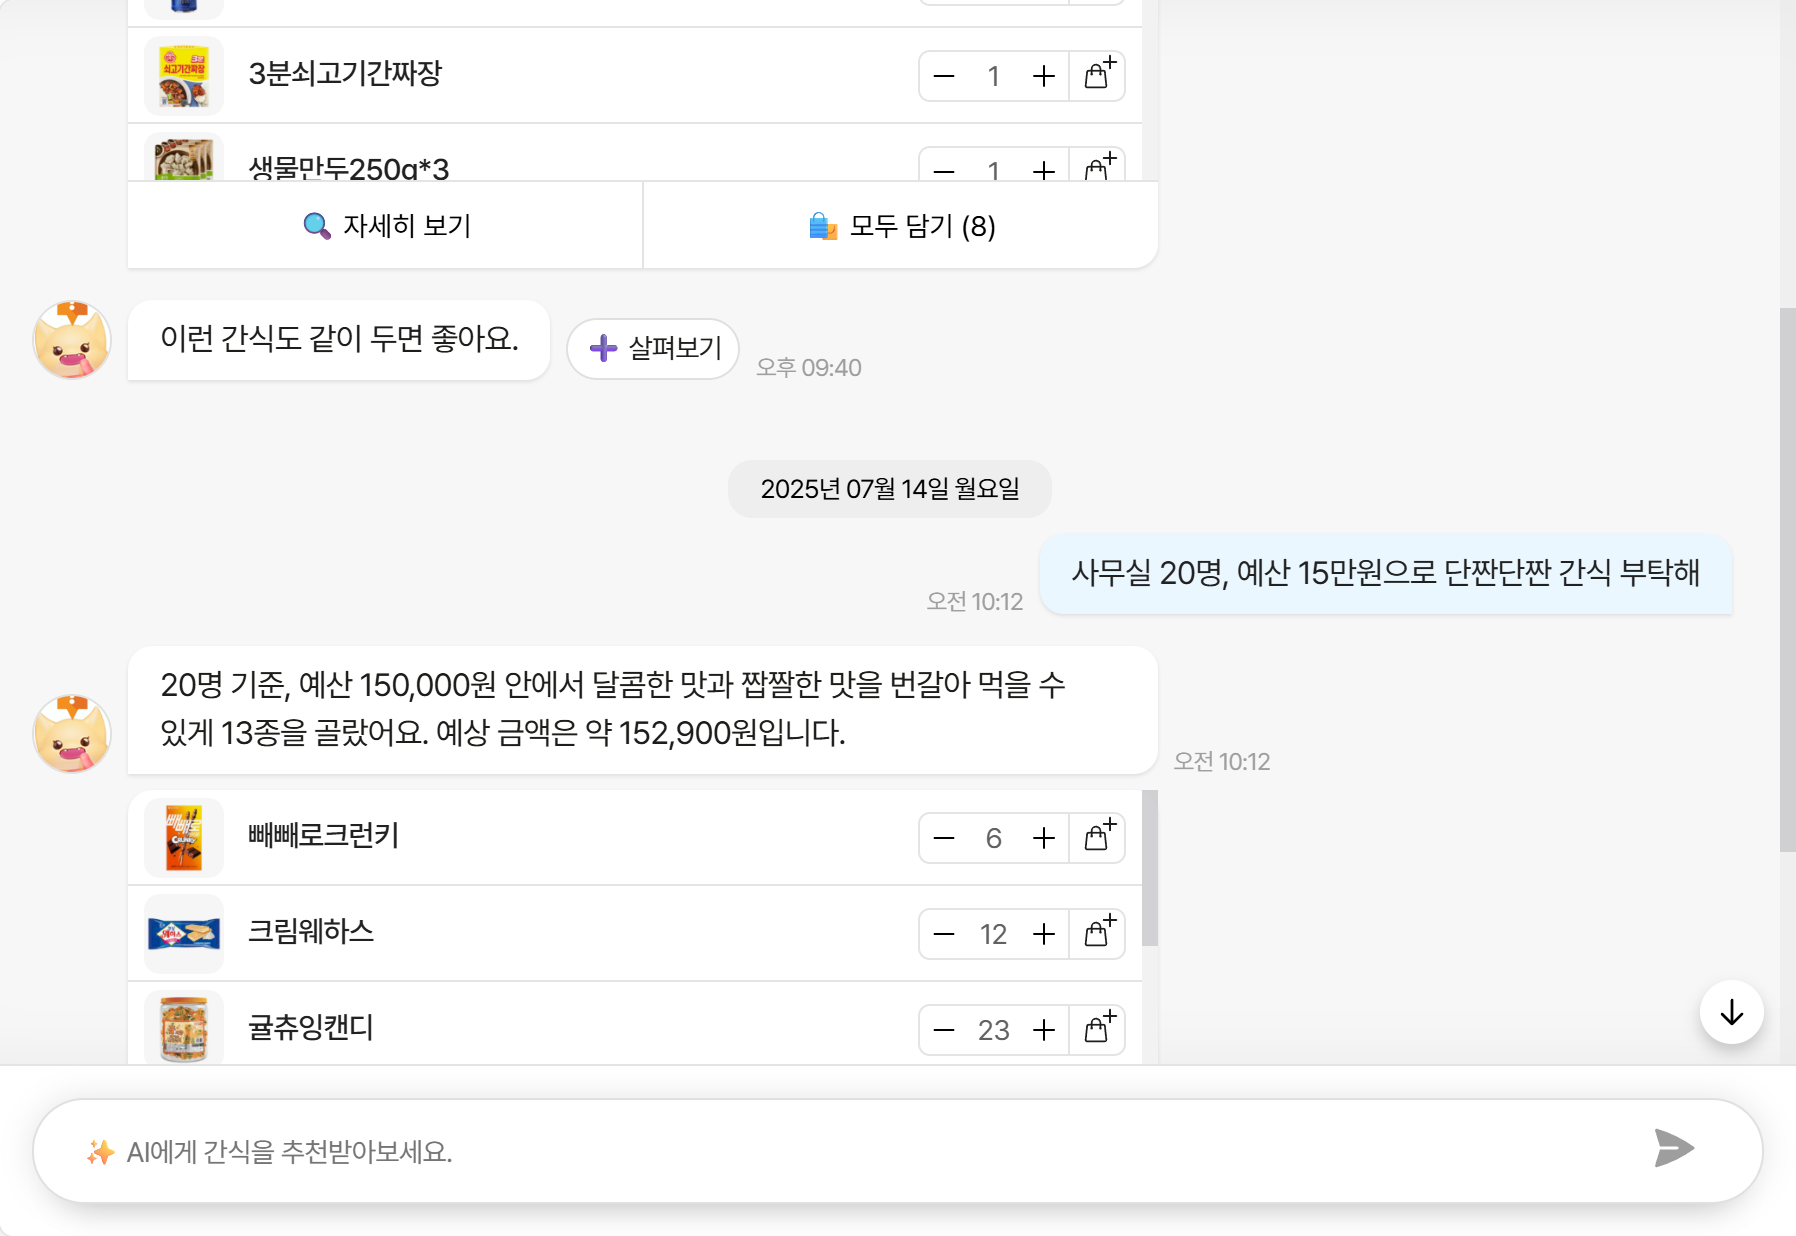
추천만 하고 끝나면 사용자는 상품을 하나하나 검색해서 다시 담아야 합니다. 그래서 상품 말풍선에서 바로 장바구니로 넘어가게 했어요.
- 상품마다 수량을 정해서 담기
- "모두 담기 (개수)"로 추천된 상품 한 번에 담기
- "자세히 보기"를 누르면 목록을 크게 펼치기 (PC는 오른쪽 사이드바, 모바일은 아래에서 올라오는 창)
곁들임 추천은 바로 펼치지 않고 "살펴보기" 버튼으로 접어 뒀습니다. 본 추천과 섞이면 뭐가 메인인지 헷갈리니까요.
뭘 물어볼지 모를 때
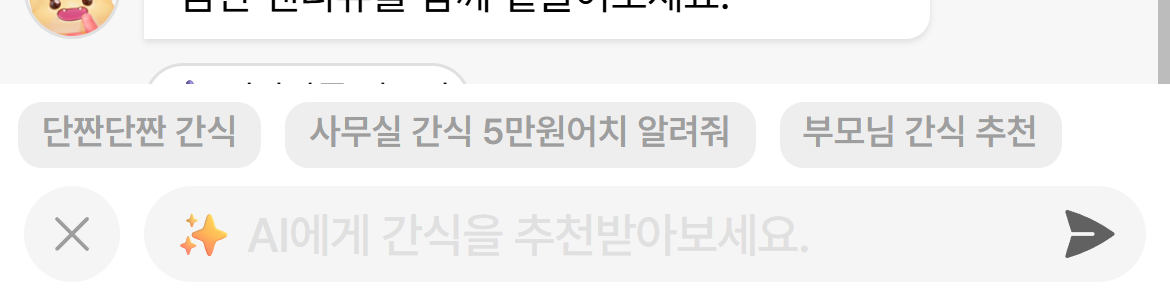
챗 화면을 처음 연 사람은 뭘 물어봐야 할지 모릅니다. 그래서 예시 질문 버튼을 뒀어요. PC는 오른쪽 사이드바에, 모바일은 입력창 옆 + 버튼을 누르면 입력창 바로 위에 뜹니다.
['단짠단짠 간식', '사무실 간식 5만원어치 알려줘', '부모님 간식 추천']누르면 입력창에 그대로 들어가서 바로 전송됩니다. 예산이 들어간 질문을 하나 넣어 둔 건 "예산을 말해도 된다"는 걸 알려주고 싶어서였습니다.
지난 대화는 백엔드가 최근 5개를 돌려주고, 화면에서는 날짜가 바뀔 때마다 구분선을 넣어 보여줍니다. 스크롤을 올려 예전 대화를 보고 있으면 맨 아래로 내려가는 버튼도 뜨고요.
실패했을 때
요청이 실패하거나 서버가 200이 아닌 응답을 주면 이 문구를 띄웠습니다.
죄송합니다. 조금 더 자세히 말씀해주시면 꼭 맞는 간식을 추천드리겠습니다.
"서버 오류"라고 하는 것보다 다시 물어볼 이유를 주는 쪽이 낫다고 생각했어요. 간식과 상관없는 질문이면 백엔드가 "간식에 해당하는 질문에만 답변 드릴 수 있어요!"라고 답해 주는데, 이건 정상 응답이라 일반 말풍선으로 나옵니다.
...그런데 이 글 쓰면서 코드를 다시 보니, 에러 문구가 AI 말풍선이 아니라 사용자 말풍선 쪽에 뜨고 있네요. 서비스가 끝난 지금은 고칠 방법도 없고요.
돌아보며
응답 형식을 프롬프트로만 부탁했습니다. 백엔드는 모델 응답에서 {부터 }까지 잘라서 JSON으로 파싱했는데, 모델이 앞뒤에 말을 붙이면 깨지기 쉬운 방식입니다. 지금이라면 OpenAI의 Structured Outputs처럼 스키마로 형식을 강제하는 기능을 쓸 것 같아요.
스트리밍이 아니었습니다. 응답을 끝까지 받은 다음 타이핑 효과로 흉내 낸 거라, 첫 글자가 뜨기까지는 결국 전체 응답 시간을 기다려야 했습니다. 실제 스트리밍이었다면 체감이 훨씬 빨랐을 거예요.
할루시네이션은 결국 코드로 막았습니다. 프롬프트를 여러 번 고쳤지만 마지막까지 믿을 수 있었던 건 DB 검증이었어요. LLM이 준 값은 사용자에게 보내기 전에 한 번은 우리 데이터와 대조한다. 이게 이 프로젝트에서 얻은 가장 큰 교훈입니다.
마치며
돌아보면 프론트에서 한 일은 LLM 자체보다 LLM을 기다리는 시간을 다루는 일이 더 많았습니다. 응답을 어떻게 받느냐보다 어떻게 보여주느냐가 사용자가 느끼는 품질을 더 크게 좌우했어요.
서비스는 종료됐지만, 이때 만든 챗 화면은 지금 봐도 꽤 마음에 듭니다. 에러 말풍선 위치만 빼고요.
참고 자료
이 글이 도움되셨나요?
공유해주시면 더 많은 사람들이 볼 수 있어요!